HPC Nedir? AI Cluster Altyapıları Rehberi
HPC (High Performance Computing), tek bir sunucunun yetmediği hesaplama işlerini yüzlerce işlemcinin paralel gücüyle çözen sistemlerin genel adı. Yapay zekâ çağında ise bu kavram, GPU merkezli AI cluster altyapılarına evrildi. Bu rehberde HPC’nin ne olduğunu, AI kümelerinin klasik HPC’den nasıl ayrıştığını ve doğru altyapının hangi bileşenlerden oluştuğunu inceliyoruz.


Yapay zekâ modelleri büyüdükçe, onları eğitmek ve çalıştırmak için gereken hesaplama gücü de katlanarak artıyor. Büyük bir dil modelinin eğitimi, tek sunucuda yıllar sürebilecek bir iş yükü demek. İşte tam bu noktada HPC ve onun modern uzantısı olan AI cluster mimarileri devreye giriyor.
HPC (Yüksek Performanslı Hesaplama) Nedir?
HPC; bilimsel simülasyonlar, iklim modelleme, genom analizi ve finansal risk hesaplamaları gibi karmaşık problemleri, yüzlerce işlemcinin aynı anda çalışmasıyla çözen sistemlerdir. Klasik bir HPC kümesi üç temel katmandan oluşur:
- Hesaplama düğümleri (compute nodes): İşi yapan sunucular; çok çekirdekli CPU’lar ve giderek daha sık GPU hızlandırıcılar içerir.
- Yüksek hızlı ağ (interconnect): Düğümleri birbirine bağlayan InfiniBand veya yüksek hızlı Ethernet altyapısı.
- Paralel depolama: Tüm düğümlerin aynı anda erişebildiği, yüksek bant genişlikli paylaşımlı depolama (Lustre, GPFS, Ceph gibi).
AI Cluster Nedir, Klasik HPC’den Farkı Ne?
AI cluster, HPC’nin derin öğrenme eğitimi ve çıkarım (inference) iş yüklerine optimize edilmiş hâlidir. Temel fark, hesaplama biriminin CPU yerine GPU olmasıdır: NVIDIA H100, H200 veya RTX PRO serisi gibi hızlandırıcıların binlerce paralel çekirdeği, yapay zekâ iş yüklerini katlanarak hızlandırır.
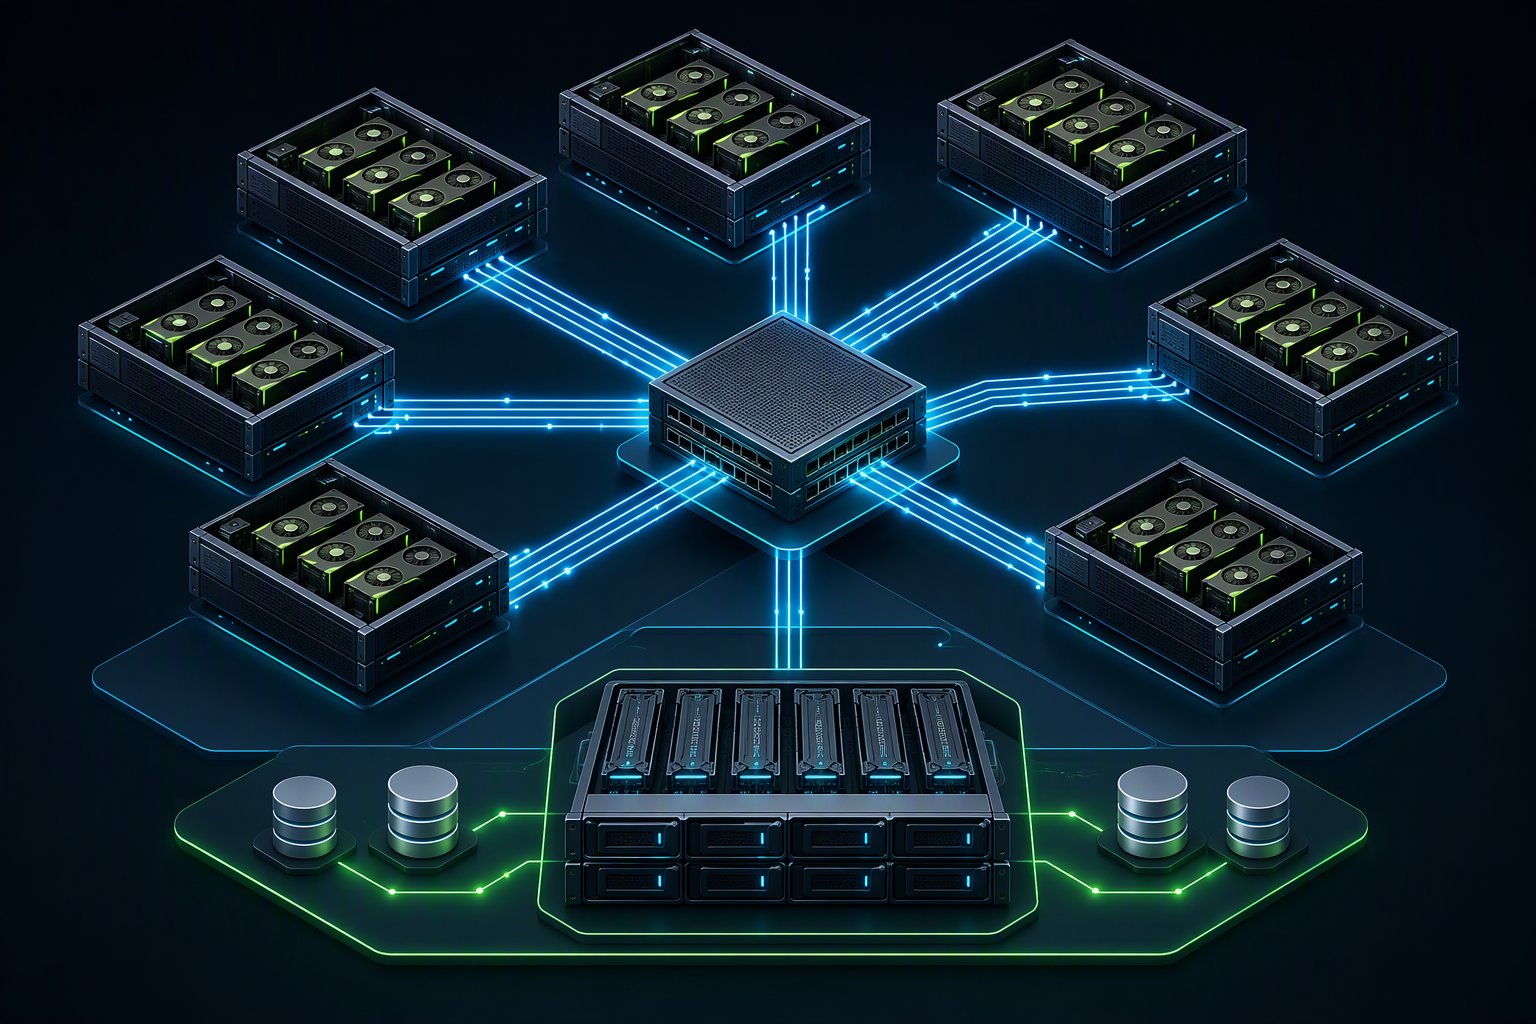
Pratik ayrım dört başlıkta özetlenebilir: klasik HPC CPU ağırlıklıdır, AI kümesi GPU ağırlıklı. Klasik HPC yüksek bant genişliği ister; AI kümesi buna ek olarak ultra düşük gecikme ister — bu yüzden 400G InfiniBand veya RoCEv2 Ethernet standarttır. Depolamada sıralı büyük okuma/yazma yerini milyonlarca küçük dosyaya rastgele erişim alır, NVMe flash öne çıkar. Yazılım tarafında ise MPI ve Slurm’un yanına Kubernetes, CUDA ve PyTorch eklenir.
Bir AI Cluster Altyapısının 5 Kritik Bileşeni
1. GPU sunucular. Kümenin kalbi. Supermicro GPU sunucular gibi yoğun platformlar tek kasada 8-10 GPU barındırabilir; NVLink/NVSwitch ile GPU’lar birbirine doğrudan bağlanır. Seçim; GPU sayısı, bellek kapasitesi, PCIe bant genişliği ve soğutma tasarımına göre yapılmalıdır.
2. Yüksek hızlı ağ. Dağıtık eğitimde GPU’lar sürekli veri alışverişi yapar. Ağ yavaşsa pahalı GPU’lar boş bekler; bu yüzden ağ tasarımı küme büyüdükçe en kritik ölçeklenebilirlik faktörü hâline gelir.
3. Veri besleme hattı ve depolama. GPU’ların saniyede terabaytlarca veri tüketebilmesi için NVMe tabanlı paralel dosya sistemleri gerekir.
GPU bekliyorsa para kaybediyorsunuz demektir. Saatte binlerce dolarlık GPU kapasitesinin boş durmaması için ağ ve depolama, en az GPU kadar ciddiye alınmalıdır.
4. Orkestrasyon ve yazılım. Kubernetes tabanlı orkestrasyon ve Slurm iş zamanlayıcı; işlerin kümeye verimli dağıtılmasını sağlar. Proxmox gibi sanallaştırma platformları ise küme kaynaklarının farklı ekiplere güvenle paylaştırılmasına imkân tanır.
5. Güç ve soğutma. 8 GPU’lu tek bir sunucu 6-10 kW çekebilir. Rack tasarımı, yedekli güç dağıtımı ve verimli soğutma —gerekirse sıvı soğutma— en baştan planlanmalıdır.
AI Cluster Kurarken Yapılan 3 Yaygın Hata
GPU’ya odaklanıp interconnect’i ikinci plana atmak, GPU yatırımını %30-40’a varan oranda boşa harcatır.
Eğitim verisi GPU’yu besleyemezse küme bekler; yatırımın geri dönüşü gecikir.
4 düğümle başlayan küme 40’a çıkacağında ağ ve güç mimarisi baştan tasarlanmak zorunda kalabilir.
Sonuç: Doğru Altyapı, Doğru Ortaklık
HPC ve AI cluster altyapıları; donanım, ağ, depolama ve yazılımın bir bütün olarak tasarlanmasını gerektiren mühendislik projeleridir. Pilot bir GPU sunucudan tam ölçekli yapay zekâ kümesine uzanan yolculukta, her katmanın birbiriyle uyumlu planlanması yatırımın verimini belirler.
AI altyapınızı birlikte tasarlayalım
2009’dan beri Supermicro Türkiye distribütörü, NVIDIA NPN Elite ve Proxmox Silver Partner olarak GPU sunucudan tam ölçekli AI kümesine uçtan uca destek sunuyoruz.