GTM TEKNOLOJİ / YAPAY ZEKÂ ALTYAPILARI
GPU bellek kapasitesi tek başına performansı belirler mi? Bu soruyu DGX Spark, RTX PRO 6000 Blackwell ve H200 modellerinin bellek mimarileri ve LLM kullanım senaryoları üzerinden yanıtlıyoruz.
273
1.597
4.800
Bu grafik model hızı değil, teorik bellek bant genişliğini gösterir.
GPU bellek kapasitesi, yapay zekâ altyapısı seçerken dikkate almamız gereken ilk ölçütlerden biridir. Ancak kapasite arttığında modelin aynı oranda hızlanmasını bekleyemeyiz. Çünkü modelin belleğe sığması ile verilerin GPU’ya ulaşma hızı farklı ihtiyaçları karşılar.
Örneğin NVIDIA DGX Spark, CPU ve GPU’nun paylaştığı 128 GB birleşik bellek sunuyor. Buna karşılık NVIDIA RTX PRO 6000 Blackwell Server Edition, 96 GB özel GDDR7 ECC VRAM kullanıyor. NVIDIA H200 SXM ise 141 GB HBM3e belleğiyle daha farklı bir sistem sınıfına hitap ediyor. Dolayısıyla bu üç çözümü yalnızca GB değerine bakarak karşılaştıramayız.
Yazı boyunca GPU bellek kapasitesi ile bant genişliğini ayrı ayrı ele alacağız. Ayrıca 70 milyar parametreli bir model örneğiyle farklı sistemlerin nerede avantaj sağlayabileceğini göstereceğiz.
GPU bellek kapasitesi ve bant genişliği arasındaki fark
GPU belleğini değerlendirirken önce iki ölçüyü ayırmalıyız. GB (gigabayt) belleğin ne kadar veri saklayabildiğini ifade eder. Buna karşılık GB/s (gigabayt/saniye), belleğin saniyede ne kadar veri aktarabildiğini gösterir.
Model ağırlıkları, KV Cache ve geçici hesaplamalar bellekte yer kaplar. Bu yüzden daha yüksek kapasite, büyük modelleri ve uzun bağlamları çalıştırmayı kolaylaştırabilir.
Bant genişliği, GPU’nun bellekteki verilere erişme hızını etkiler. Özellikle bellek aktarımıyla sınırlanan uygulamalarda bu değer önemli hâle gelir.
Bir depo örneği düşünelim: Kapasite, depoya kaç ürün sığdığını; bant genişliği ise ürünlerin ne kadar hızlı taşındığını anlatır. Büyük bir depo daha çok ürün saklar. Ancak sevkiyat yavaşsa toplam iş süresi yine uzar.
Önemli ayrım
Bununla birlikte yüksek bellek bant genişliği, uygulamanın aynı oranda hızlanacağını garanti etmez. GPU’nun hesaplama gücü, model mimarisi, yazılım ve eş zamanlı kullanıcı sayısı da sonucu etkiler.
DGX Spark, RTX PRO 6000 ve H200: GPU bellek kapasitesi karşılaştırması
Aşağıdaki tabloda üç NVIDIA çözümünü aynı ölçütlerle karşılaştırıyoruz. Böylece GPU bellek kapasitesi ile aktarım hızı arasındaki fark daha açık hâle geliyor.
Dar ekranlarda tabloyu sağa kaydırarak bütün sütunları görebilirsiniz.
| Özellik | DGX Spark | RTX PRO 6000 Server | H200 SXM |
|---|---|---|---|
| Bellek kapasitesi | 128 GB | 96 GB | 141 GB |
| Bellek teknolojisi | LPDDR5X | GDDR7 ECC | HBM3e |
| Bellek yapısı | CPU ve GPU için birleşik | GPU’ya özel VRAM | GPU’ya özel HBM |
| Bant genişliği | 273 GB/s | 1.597 GB/s | 4.800 GB/s |
| Öne çıkan kullanım | Yerel AI geliştirme ve test | Kurumsal AI ve çıkarım | Büyük ölçekli AI ve HPC |
Tablodaki bant genişliği değerleri, NVIDIA’nın ilgili yapılandırmalar için açıkladığı teorik üst sınırları gösterir. Karşılaştırmada H200’ün SXM varyantını esas aldık. Dolayısıyla sonuçları gerçek uygulama hızı olarak yorumlamamak gerekir.
128 GB birleşik bellek: NVIDIA DGX Spark
NVIDIA DGX Spark, GB10 Grace Blackwell Superchip kullanan kompakt bir yapay zekâ bilgisayarıdır. CPU ve GPU, 128 GB LPDDR5X birleşik bellek havuzunu paylaşır. Böylece geliştiriciler, yüksek bellek kapasitesi isteyen modelleri masaüstünde deneyebilir.
Ancak 128 GB birleşik bellek, aynı miktarda bağımsız VRAM anlamına gelmez. İşletim sistemi ve CPU da bu havuzu kullanır. Bu nedenle model için kalan alan, sistemin o anki bellek ihtiyacına göre değişir.
DGX Spark 273 GB/s teorik bellek bant genişliği sunar. Dolayısıyla bu sistemi öncelikle yerel AI geliştirme, prototipleme, model testleri ve uygun ölçekte ince ayar (fine-tuning) için değerlendirebilirsiniz.

Yerel model geliştirme, deneyler ve prototipleme
96 GB GDDR7 VRAM: RTX PRO 6000 Blackwell Server Edition
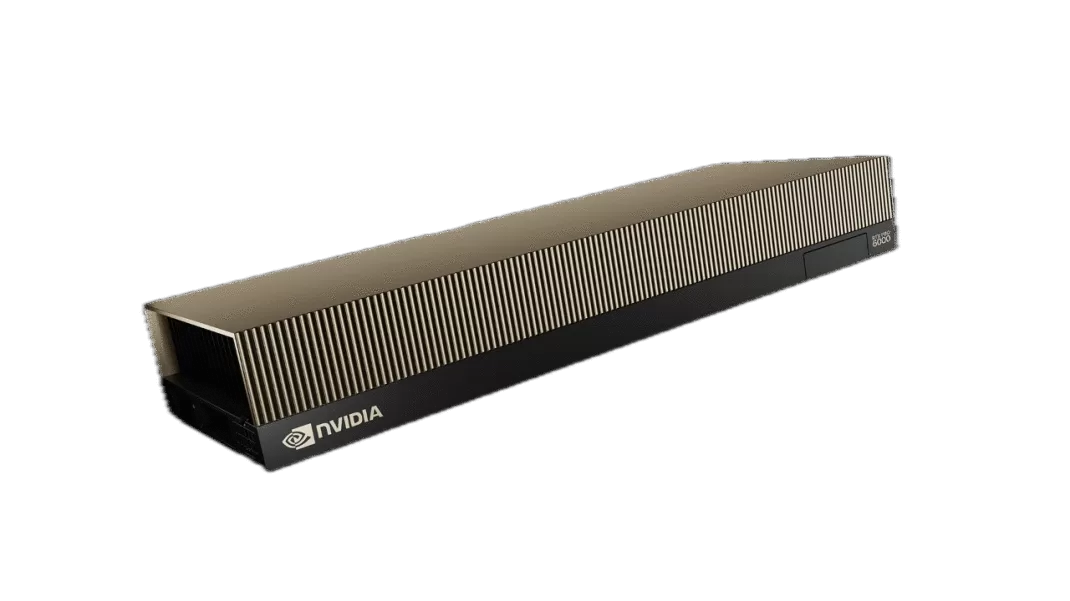
NVIDIA, RTX PRO 6000 Blackwell Server Edition modelini sunucu ortamındaki yapay zekâ ve profesyonel görsel hesaplama işleri için sunuyor. GPU, 96 GB GDDR7 ECC VRAM ve 1.597 GB/s teorik bant genişliği sağlıyor.
DGX Spark’tan farklı olarak RTX PRO 6000, hesaplamalar için özel bir GPU bellek havuzu kullanır. Bu nedenle model VRAM’e sığdığında ve iş yükü yoğun bellek erişimi gerektirdiğinde avantaj sağlayabilir.
Örneğin şirket içi bir RAG uygulamasında model boyutunun yanında eş zamanlı kullanıcı sayısı ve yanıt süresi önem taşır. KV Cache de ek GPU belleği tüketir. Bu yüzden GPU bellek kapasitesi kadar CPU, RAM, depolama ve ağ yapısını da birlikte planlamalıyız.
Üretim ortamında yapay zekâ çıkarımı ve profesyonel iş yükleri
141 GB HBM3e: NVIDIA H200 SXM
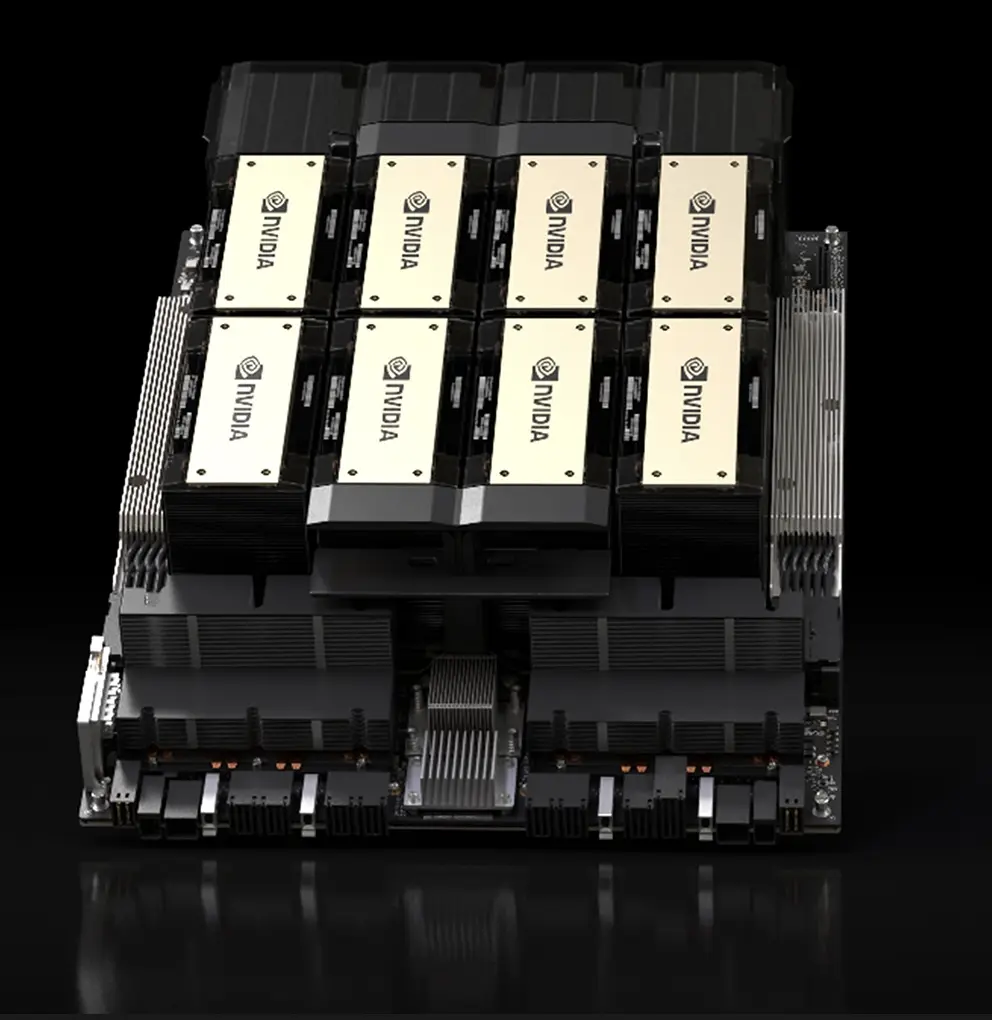
NVIDIA H200 SXM, büyük yapay zekâ modelleri ve yüksek performanslı hesaplama (HPC) için 141 GB HBM3e bellek sunar. Ayrıca 4,8 TB/s teorik bellek bant genişliğiyle yüksek veri aktarımı gerektiren iş yüklerini hedefler.
HBM mimarisinde üreticiler, bellek yongalarını dikey olarak istifler ve gelişmiş paketleme yöntemleriyle GPU’ya yakın yerleştirir. Böylece sistem, geniş bellek arayüzü üzerinden çok yüksek aktarım hızlarına ulaşabilir.
Ancak H200’ün bütün avantajını HBM3e’ye bağlamak doğru olmaz. Özellikle çok GPU’lu çalışmalarda hesaplama mimarisi, GPU bağlantıları ve yazılım altyapısı da performansı etkiler.
Büyük ölçekli çıkarım, eğitim ve HPC
Somut örnek: 70 milyar parametreli bir LLM ne kadar yer kaplar?
Bir dil modelinin ağırlıklarını bellekte saklamak için gereken alan, parametre sayısına ve sayısal hassasiyete bağlıdır. Örneğin 70 milyar parametreli bir model için yalnızca model ağırlıklarını şöyle hesaplayabiliriz:
Tablodaki değerler sadece ağırlıkların teorik ve basitleştirilmiş boyutlarını gösterir. Ancak gerçek uygulamalar quantization metadata, KV Cache ve geçici çalışma alanları için ek bellek kullanır. Bu yüzden GPU bellek kapasitesi planında ağırlıkların üzerine yeterli çalışma payı eklemeliyiz.
Örneğin 4-bit ağırlıkları teorik olarak yaklaşık 35 GB yer kaplayan bir model, uygun yazılımla hem DGX Spark hem de RTX PRO 6000 üzerinde çalışabilir. Yine de belleğe sığan modelin yeterince hızlı yanıt vereceğini varsayamayız.
Neden yalnızca model dosyasının boyutuna bakmıyoruz?
Özellikle bağlam uzunluğu ve eş zamanlı istek sayısı arttığında KV Cache daha fazla alan isteyebilir. Bu nedenle sunucu seçmeden önce gerçek kullanıcı yüküne yakın testler yapmalıyız.
LPDDR5X, GDDR7 ve HBM3e hangi iş yüklerinde öne çıkıyor?
LPDDR5X
Birleşik, enerji odaklı sistemler
LPDDR5X, DGX Spark gibi kompakt sistemlerde yüksek bellek kapasitesiyle enerji verimliliğini bir araya getirir.
GDDR7
Yüksek hızlı profesyonel GPU’lar
GDDR7, RTX PRO 6000 gibi profesyonel GPU’larda yüksek veri aktarım hızı sağlar. Bu nedenle AI çıkarımı, render ve görsel hesaplamalarda öne çıkar.
HBM3e
Çok yüksek bant genişliği
HBM3e, H200 gibi veri merkezi GPU’larına çok yüksek bant genişliği sağlar. Özellikle büyük AI ve HPC iş yükleri bu kapasiteden yararlanabilir.
Sonuç olarak hiçbir bellek teknolojisini her iş yükü için tek doğru seçenek sayamayız. Bunun yerine modelin özelliklerini, sistem mimarisini ve performans beklentisini birlikte değerlendirmeliyiz.
GPU bellek kapasitesi seçerken hangi soruları sormalıyız?
- Modelin parametre sayısı, ağırlık biçimi ve gerçek bellek ihtiyacı nedir?
- Uygulama geliştirme ve test için mi, üretim ortamı için mi kullanılacak?
- Aynı anda kaç kullanıcıya hizmet verilecek, hedef yanıt süresi ne olacak?
- Context window ve KV Cache için ne kadar ek bellek gerekecek?
- Tek GPU yeterli mi, ileride çoklu GPU ve yüksek hızlı bağlantı gerekecek mi?
- Sunucunun güç, soğutma, CPU, RAM ve ağ altyapısı iş yükünü destekliyor mu?
Örneğin birkaç geliştiricinin yerel testleri ile yüzlerce kişiye hizmet veren bir uygulamanın ihtiyaçları aynı değildir. Bu yüzden GPU bellek kapasitesi, bant genişliği ve hesaplama performansını birlikte değerlendirmeliyiz.
Sık sorulan sorular
128 GB birleşik bellek, 96 GB VRAM’den daha mı güçlüdür?
Hayır, tek başına GB değerinden böyle bir sonuç çıkaramayız. DGX Spark’ta CPU ve GPU 128 GB belleği paylaşır. Buna karşılık RTX PRO 6000, GPU’ya ayrılmış 96 GB hızlı VRAM kullanır. Dolayısıyla kullanım amacını ve hız hedefini de dikkate almalıyız.
Bant genişliği 5,8 kat yüksekse model de 5,8 kat hızlı mı çalışır?
Hayır. Bu oran yalnızca NVIDIA’nın açıkladığı teorik bellek bant genişliği değerlerini karşılaştırır. Gerçekte token üretim hızını GPU’nun hesaplama gücü, model mimarisi ve eş zamanlı istekler de etkiler.
70 milyar parametreli bir model 96 GB VRAM’e sığar mı?
Bu durum modele ve sayısal hassasiyete bağlıdır. Örneğin 4-bit ağırlıklar teorik olarak yaklaşık 35 GB yer tutar. Ancak KV Cache ve geçici çalışma alanları toplam bellek ihtiyacını artırır.
Sonuç: Daha fazla GB, her zaman daha iyi performans değildir
DGX Spark, 128 GB birleşik belleğiyle yerel AI geliştirmeyi kolaylaştırır. Buna karşılık RTX PRO 6000 Blackwell Server Edition, 96 GB yüksek hızlı GDDR7 VRAM ile kurumsal sunucu iş yüklerine hitap eder. H200 SXM ise 141 GB HBM3e bellek ve yüksek bant genişliğiyle daha büyük AI ve HPC sistemlerine odaklanır.
Kısacası doğru GPU bellek kapasitesi, modelinizin gereksinimlerine ve beklediğiniz performansa bağlıdır. Bu yüzden yalnızca “Kaç GB belleğe ihtiyacım var?” diye sormak yeterli değildir. “Modelim için nasıl bir bellek, bant genişliği ve sistem mimarisi gerekli?” sorusuna da yanıt aramalıyız.