Yapay Zekâ Altyapısı
PCIe ve SXM Nedir? GPU Sunucularında Performans, Bağlantı ve Kullanım Farkları
PCIe ve SXM nedir?
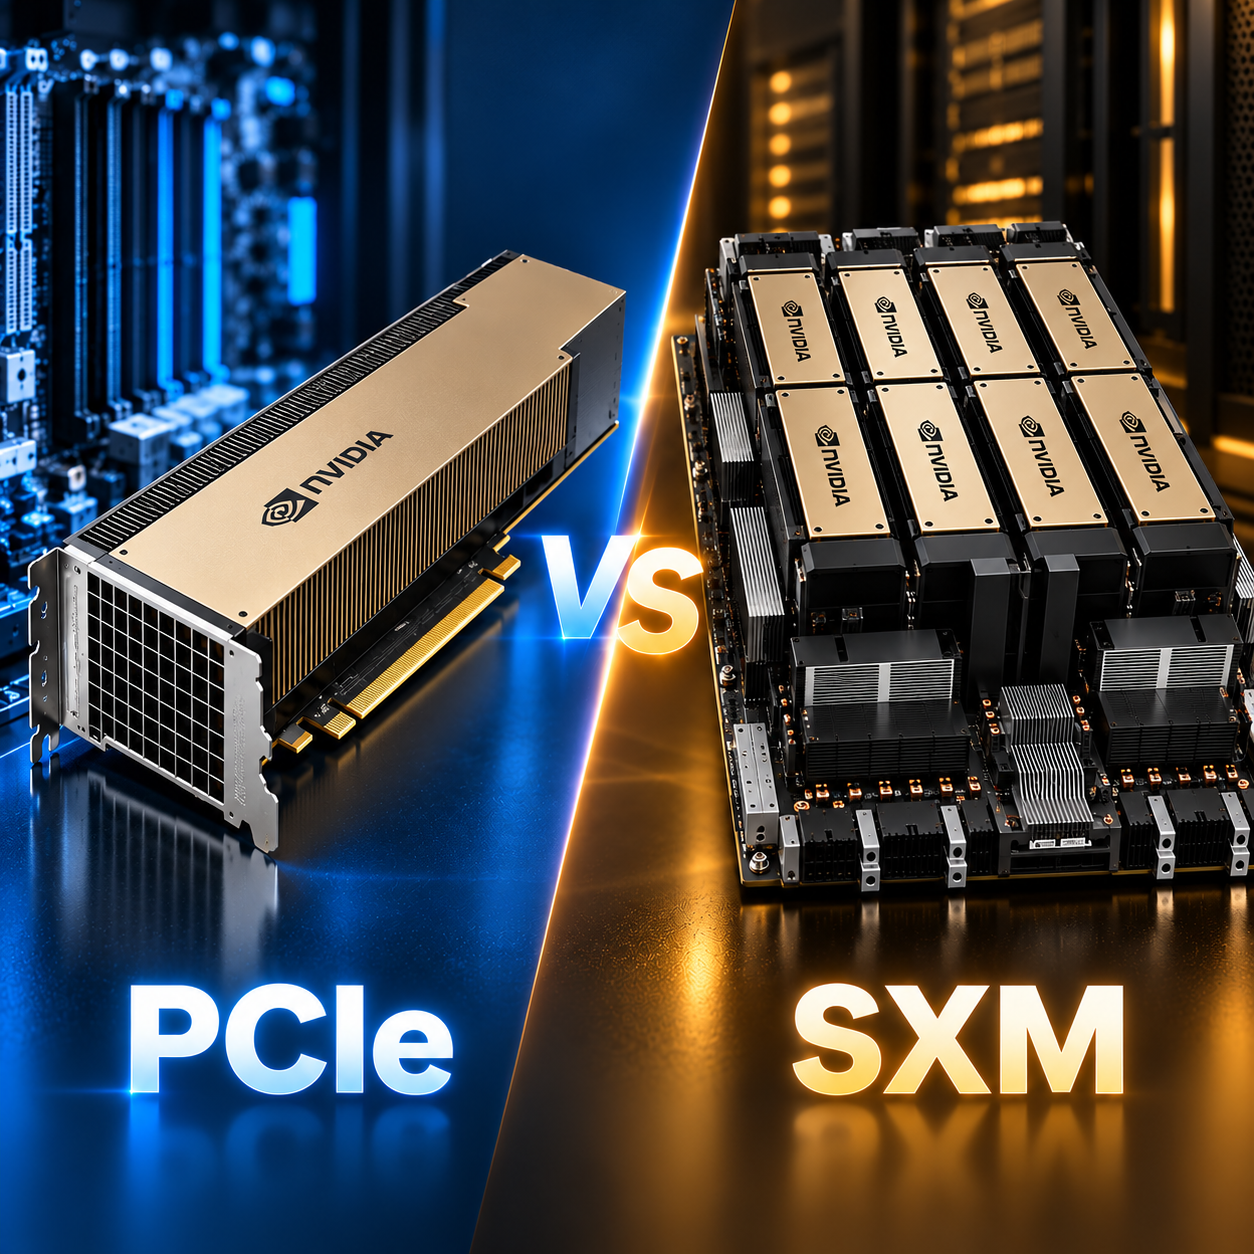
PCIe GPU
Bu form faktöründe GPU kartını anakart üzerindeki uyumlu PCIe genişleme yuvasına yerleştirirsiniz. Bu kartları çeşitli sunucu ve iş istasyonu tasarımlarında kullanabilirsiniz. Bununla birlikte kurulum öncesinde fiziksel yuvayı, güç kaynağını, hava akışını ve üretici desteğini mutlaka kontrol edin.
SXM GPU
SXM, GPU’yu özel bir taşıyıcı kart (örneğin NVIDIA HGX baseboard) üzerinde konumlandıran modüler form faktörüdür. Ayrıca uyumlu HGX yapılandırmaları, GPU’lar arasında yüksek bant genişlikli NVLink ve NVSwitch bağlantıları sağlayabilir.
Önemli ayrım: PCIe ve SXM, GPU’nun işlemci mimarisini değil, sunucudaki fiziksel konumunu ve bağlantı yöntemini tanımlar. Ayrıca SXM tabanlı HGX platformları da CPU ile GPU arasındaki iletişimde PCIe kullanır; NVLink/NVSwitch ise GPU’lar arası iletişimde öne çıkar.
Teknik detay: PCIe bant genişliği
PCIe Gen5 x16 bağlantısının teorik çift yönlü toplam bant genişliği yaklaşık 128 GB/s’dir (her yönde yaklaşık 64 GB/s). Ancak bu değer yalnızca PCIe bağlantısını açıklar; GPU’nun HBM bellek bant genişliğinden farklıdır. Üstelik PCIe kartlar da NVLink kullanabilir: H100 PCIe, uygun bir NVLink köprüsüyle iki GPU’yu; H200 NVL ise uyumlu köprülerle 2 veya 4 GPU’lu grupları birbirine bağlayabilir.
NVLink ve NVSwitch nasıl çalışır?
Yüksek hızlı NVLink teknolojisi, uyumlu NVIDIA GPU’ları arasında veri aktarımını hızlandırır. NVSwitch ise birden fazla GPU arasındaki NVLink trafiğini anahtarlayarak HGX gibi platformlarda kapsamlı GPU-GPU iletişim topolojileri oluşturur. Bu nedenle büyük modelleri GPU’lara dağıtan sistemlerde bağlantı yapısı önem kazanır.
Örneğin tensor paralelliğinde GPU’lar aynı katmanda birlikte hesaplama yapar; MoE modellerinde ise uzmanlar kendi aralarında veri aktarır. Bu tür uygulamalarda iletişim bant genişliği, toplam çalışma süresini etkileyebilir. Öte yandan farklı istekleri bağımsız işleyen GPU’lar, aynı düzeyde bağlantı bant genişliğine ihtiyaç duymayabilir.
Teknik detay: NVLink nesilleri ve GPU belleği
NVIDIA’nın referans değerlerine göre Hopper neslinde dördüncü nesil NVLink, GPU başına 900 GB/s; HGX B200’de beşinci nesil NVLink, GPU başına 1,8 TB/s çift yönlü toplam bant genişliği sunar. Sekiz GPU’lu sistemlerde NVIDIA, HGX H100/H200 için toplam bağlantı bant genişliğini 7,2 TB/s, HGX B200 içinse 14,4 TB/s olarak verir. Dolayısıyla bu teorik bağlantı değerlerinden uygulamanın gerçek performansını doğrudan çıkaramayız.
NVLink, GPU belleklerini fiziksel olarak tek bir belleğe dönüştürmez. Sekiz H200 GPU’nun toplamı 1.128 GB bellek kapasitesidir; ancak bu kapasiteyi etkili kullanmak için uygun model bölme yöntemleri ve yazılım altyapısı gerekir.
NVIDIA GPU modellerinin karşılaştırması
Aşağıdaki teknik değerler her bir GPU’yu temsil eder. Buna karşılık sistemin toplam performansını sunucu topolojisi, GPU sayısı, yazılım, güç ayarları ve soğutma tasarımı belirler.
| Özellik | H100 PCIe | H100 SXM | H200 SXM | H200 NVL | HGX B200 (GPU başına) |
|---|---|---|---|---|---|
| Form faktörü | PCIe kart | SXM | SXM | PCIe kart | SXM (HGX) |
| GPU belleği | 80 GB HBM2e | 80 GB HBM3 | 141 GB HBM3e | 141 GB HBM3e | 180 GB HBM3e |
| Bellek bant genişliği | 2 TB/s | 3,35 TB/s | 4,8 TB/s | 4,8 TB/s | 8 TB/s’ye kadar |
| Maksimum TDP | 350 W | 700 W | 700 W | 600 W | 1.000 W |
| GPU’lar arası bağlantı | 2 GPU NVLink köprüsü: 600 GB/s | NVLink/NVSwitch: 900 GB/s | NVLink/NVSwitch: 900 GB/s | 2/4 GPU NVLink köprüsü: GPU başına 900 GB/s | NVLink/NVSwitch: 1,8 TB/s |
| Örnek sistem seçenekleri | Uyumlu sunucularda 1–8 GPU | HGX: 4 veya 8 GPU | HGX: 4 veya 8 GPU | MGX: 8 GPU’ya kadar* | HGX: 8 GPU |
* H200 NVL sisteminde sekiz fiziksel GPU bulunabilse de NVLink köprü bağlantıları tüm sekiz GPU’yu tek bir NVSwitch alanı hâline getirmez. TDP değerleri NVIDIA’nın açıkladığı üst sınırları ifade eder; üretici ve sistem yöneticisi yapılandırmaya göre daha düşük güç sınırları seçebilir. Burada B200 için HGX B200 sürümünün değerlerini esas alıyoruz. Ayrıca H100 PCIe ile H100 NVL farklı ürünlerdir: 94 GB belleğe sahip H100 NVL, ayrı bir PCIe varyantıdır.
Bellek kapasitesi ve bant genişliği neden önemlidir?
Kapasite, GPU’nun barındırabileceği model ağırlıklarını ve çalışma verilerini etkiler. Bant genişliği ise GPU’nun bellekteki verilere ne hızla erişebildiğini belirler. Özellikle LLM’lerin token üretim (decode) aşamasında bellek erişimi performans üzerinde önemli rol oynayabilir.
H200 SXM, H100 SXM’ye kıyasla yaklaşık %76 daha yüksek bellek kapasitesi (141 GB / 80 GB) ve yaklaşık %43 daha yüksek bellek bant genişliği (4,8 TB/s / 3,35 TB/s) sağlar. Bununla birlikte bu fark, her iş yükünde aynı oranda hızlanma sağlamaz.
Teknik detay: 70B modelin bellek hesabı
70 milyar parametreli bir modelin yalnızca FP16 formatındaki ağırlıkları kabaca 140 GB yer kaplar. Oysa çıkarım sırasında KV cache, geçici ara veriler ve çalışma zamanı için ek bellek gerekir. Dolayısıyla 141 GB belleğe sahip tek bir GPU’nun, 70B parametreli her FP16 modeli her bağlam uzunluğunda sorunsuz çalıştıracağını varsayamayız. Bu nedenle kuantizasyon ve bellek optimizasyonu uygulayabilir ya da modeli birden fazla GPU’ya dağıtabilirsiniz.
H200 NVL ve H200 SXM modellerinin her ikisi de 141 GB HBM3e ve 4,8 TB/s bant genişliği sunar. Aralarındaki asıl fark bellek miktarı değil; form faktörü, güç sınırı ve çoklu GPU bağlantı topolojisidir.
Güç tüketimi ve soğutma
Hem PCIe kartlarda hem de SXM platformlarında GPU modeli ve sistem tasarımı gerçek soğutma ihtiyacını belirler. Örneğin veri merkezlerine yönelik pek çok PCIe GPU pasif soğutma kullanır. Bu kartların güvenli çalışması için sunucu fanlarının güçlü hava akışını doğru yönde oluşturması gerekir. Dolayısıyla standart PCIe yuvası olan her kasaya sunucu GPU’su takmak doğru değildir.
H200 SXM GPU başına 700 W’a, H200 NVL ise 600 W’a kadar TDP seçenekleri sunar. HGX B200’de sınır GPU başına 1.000 W’a kadar çıkabilir. Ancak daha düşük TDP tek başına maliyet avantajı veya daha iyi enerji verimliliği garanti etmez. Bu nedenle işin tamamlanma süresini ve sunucunun toplam enerji tüketimini birlikte değerlendirmek gerekir.
SXM sistemlerde sıvı soğutma zorunlu mu?
Hayır, zorunlu değil. SXM GPU kullanan sunucular hava soğutmasıyla da çalışabilir. Örneğin Supermicro SYS-822GS-NBRT, sekiz adet NVIDIA HGX B200 GPU’yu destekleyen 8U, hava soğutmalı bir sistemdir. Supermicro, bu modelde GPU başına 1.000 W TDP desteği belirtir. Bununla birlikte böyle bir sunucu yüksek hava akışı, uygun elektrik beslemesi ve veri merkezi seviyesinde soğutma gerektirir; dolayısıyla ofiste sessiz çalışacağını varsaymamak gerekir.
Teknik detay: Sunucu örneği ve planlama
Supermicro SYS-822GS-NBRT; NVIDIA HGX B200 8-GPU SXM6, NVSwitch, çift Intel Xeon 6700/6500 serisi işlemci desteği ve 32 DIMM yuvası sunar. Bu nedenle kurulumdan önce güç dağıtımını, raf yükünü, sıcaklığı, ses düzeyini, elektrik devresini ve iklimlendirme kapasitesini ayrıca değerlendirin. Ayrıca yüksek yoğunluklu kurulumlar için farklı üreticiler sıvı soğutmalı çözümler de sunar.
Mevcut sunucuya PCIe GPU eklemek mümkün mü?
Bazı sunuculara ekleyebilirsiniz; ancak yalnızca PCIe yuvasına bakarak uyumluluk kararı veremezsiniz. Bu nedenle GPU desteği için üreticinin uyumluluk listesine ve yapılandırma kılavuzlarına bakın.
Özellikle şu unsurları kontrol edin:
- Fiziksel alan: Kartın uzunluğu, yüksekliği, kapladığı slot sayısı ve uygun yükseltici (riser) seçenekleri.
- Elektrik: Güç kaynağının kapasitesi ve kartın ihtiyaç duyduğu yardımcı güç bağlantıları.
- Soğutma: GPU’nun pasif/aktif soğutma tasarımı, gerekli hava akışı ve sunucunun fan profili.
- Platform desteği: Anakart, BIOS/firmware, PCIe topolojisi, sürücüler ve varsa NVLink köprüsü uyumluluğu.
Aksi hâlde özellikle yüksek TDP’li GPU’larda yanlış kasa seçimi ısınma nedeniyle performansı düşürebilir veya donanım uyumluluğunu engelleyebilir.
Ölçeklenebilirlik: GPU sayısından fazlası
İş yükünüzü bağımsız parçalara ayırabiliyorsanız — örneğin her GPU farklı çıkarım isteklerini işliyorsa — PCIe tabanlı bir sunucu tercih edebilirsiniz. Buna karşılık tek bir modeli çok sayıda GPU’ya dağıtan eğitim veya yoğun çıkarım senaryolarında GPU’lar arası iletişim kapasitesi daha önemli hâle gelir; HGX platformları bu noktada öne çıkabilir.
Teknik detay: Scale-up ve scale-out
Scale-up, tek sunucudaki GPU’ların yüksek hızlı bağlantılar üzerinden birlikte çalışmasını ifade eder. HGX H100/H200/B200 platformlarında NVLink ve NVSwitch bu ihtiyaca hizmet eder. Scale-out yaklaşımında ise sunucuları InfiniBand veya yüksek hızlı Ethernet üzerinden birbirine bağlarsınız. Çok düğümlü eğitimde ağ kartı sayısı, bağlantı hızı, topoloji ve yazılım altyapısı da performansı belirler. NVLink de sunucular arası ağ ihtiyacını ortadan kaldırmaz.
İş yüküne göre PCIe mi SXM mi tercih etmeli?
| İş yükü | Platform seçeneği | Karar kriteri |
|---|---|---|
| Küçük/orta LLM çıkarımı, RAG, kurumsal asistan | H100 PCIe veya H200 NVL | Modelin VRAM ihtiyacı, kuantizasyon, bağlam uzunluğu ve eşzamanlı kullanıcı sayısı |
| 70B ve üzeri modeller, uzun bağlam | H200 NVL (uygun 2/4 GPU grupları) veya HGX H200 | KV cache, modelin GPU’lara dağılımı ve GPU-GPU iletişimi |
| Yoğun kullanıcılı LLM/MoE servisi | HGX H200 / HGX B200 | Gerçek iş yükünde gecikme, toplam token/s ve iletişim topolojisi |
| LoRA / QLoRA fine-tuning | İhtiyaca göre PCIe veya HGX | Model boyutu, eğitim yöntemi, GPU belleği ve bütçe |
| Büyük ölçekli model eğitimi | HGX H100/H200/B200 + uygun yüksek hızlı ağ | GPU’lar arası senkronizasyon, ölçekleme ve veri merkezi altyapısı |
| HPC ve bilimsel hesaplama | İş yüküne bağlı PCIe / HGX | GPU’ların bağımsız mı yoksa sıkı koordinasyonla mı çalıştığı |
Bu tablo bir başlangıç rehberidir. Nihai seçimde ise benchmark sonuçlarını, hedef gecikmeyi, enerji bütçesini, kasa uyumluluğunu, yazılım lisanslarını ve toplam sahip olma maliyetini birlikte değerlendirin.
Sık sorulan sorular
PCIe GPU ile model eğitimi mümkün mü?
Evet, PCIe GPU’larla çeşitli model eğitimi ve fine-tuning işlemleri gerçekleştirebilirsiniz. Birden fazla GPU arasında sık veri alışverişi gerektiren büyük eğitimlerde, yüksek hızlı NVLink/NVSwitch topolojisi avantaj sağlayabilir.
H200 NVL ile H200 SXM arasındaki temel fark nedir?
Her ikisi de GPU başına 141 GB HBM3e ve 4,8 TB/s bellek bant genişliğine sahiptir. PCIe kart formundaki H200 NVL, 2/4 GPU NVLink köprü gruplarını destekler; SXM biçimindeki H200 ise HGX platformunda NVSwitch üzerinden daha kapsamlı çoklu GPU bağlantısı sunar. Maksimum TDP sırasıyla 600 W ve 700 W’tır.
Her PCIe sunucusu H200 NVL ile uyumlu mudur?
Yalnızca PCIe yuvasının varlığı uyumluluğu garanti etmez. Bu yüzden kartın fiziksel boyutunu, güç girişini, güç kaynağını, soğutma ihtiyaçlarını, firmware’i ve üreticinin destek listesini kontrol edin.
SXM GPU’lar için sıvı soğutma şart mı?
Şart değil. Örneğin Supermicro SYS-822GS-NBRT, HGX B200 için hava soğutması kullanır. Dolayısıyla soğutma türünü ve tesis gereksinimlerini sistemin tasarımına göre değerlendirin.
NVLink GPU belleklerini fiziksel olarak birleştirir mi?
Birleştirmez. Her GPU kendi fiziksel belleğini korur. Bununla birlikte model paralelliği ve uygun yazılımla GPU belleklerinden koordineli biçimde yararlanabilirsiniz.
Kaynakça
- NVIDIA H100 — PCIe ve SXM teknik özellikleri, bellek ve NVLink.
- H200 GPU (NVIDIA) — SXM ve NVL sürümleri, bellek kapasitesi ve güç değerleri.
- HGX Referans Mimarisi (NVIDIA) — H100, H200 ve B200 platformları ile NVLink/NVSwitch bağlantıları.
- H200 NVL Referans Mimarisi (NVIDIA) — çoklu GPU bağlantı düzeni ve ölçeklenebilirlik.
- Supermicro SYS-822GS-NBRT — HGX B200 sunucu yapılandırması ve hava soğutma.
Projenize uygun GPU sunucusunu birlikte belirleyelim.